OpenWrt 中的 IPv6 涉及多个环节,只关其中一个往往不彻底:
| 层面 | 负责的事 | 不关的后果 |
|---|---|---|
| WAN 接口 | 从运营商获取 IPv6 地址/前缀 | 路由器仍拿到公网 IPv6 |
| LAN 接口 + odhcpd | 向局域网设备下发 IPv6 地址 | 客户端仍获得 240x: / fdxx: 地址 |
| 内核协议栈 | IPv6 本身的运行 | 接口仍可自动生成 IPv6 地址 |
| DNS | 返回 AAAA(IPv6)记录 | 客户端尝试 IPv6 连接,导致网页卡顿 |
| 代理插件 | 插件自身的 IPv6 代理/解析 | 插件绕过上述设置重新引入 IPv6 |
uci delete network.wan6 # 删除 WAN6 接口(不存在会提示 Entry not found,可忽略)
uci set network.wan.ipv6='0' # PPPoE 拨号时阻止自动获取 IPv6
uci set network.lan.ipv6='0'
uci delete network.lan.ip6assign # 取消 LAN 的 IPv6 前缀分配
uci delete network.globals.ula_prefix # 删除 ULA 前缀(fdxx::/48)
uci commit networkuci set dhcp.lan.ra='disabled'
uci set dhcp.lan.dhcpv6='disabled'
uci set dhcp.lan.ndp='disabled'
uci delete dhcp.wan6 2>/dev/null
uci commit dhcp
/etc/init.d/odhcpd stop
/etc/init.d/odhcpd disableuci set dhcp.@dnsmasq[0].filter_aaaa='1' # 23.05 及以上版本支持
uci commit dhcp旧版本若无此选项,可在/etc/dnsmasq.conf中加入filter-AAAA(需 dnsmasq 2.87+)。
cat >> /etc/sysctl.conf <<'EOF'
net.ipv6.conf.all.disable_ipv6=1
net.ipv6.conf.default.disable_ipv6=1
EOF
sysctl -p⚠️ 这里没有禁用lo(回环接口)的 IPv6。部分服务(如 uhttpd 及某些插件)会监听::1,禁用后可能导致异常。
如果路由器装了 OpenClash 等代理插件,DNS 会被插件接管(Fake-IP 模式下解析结果为 198.18.x.x),必须在插件中同步关闭 IPv6。
进入 服务 → OpenClash → 插件设置:
IPv6 设置 标签页
DNS 设置 标签页
如直接编辑 mihomo(Clash Meta)配置文件,设置顶层ipv6: false以及dns:下的ipv6: false。
/etc/init.d/network restart
/etc/init.d/dnsmasq restart
# 建议最后执行一次 reboot,确认设置重启后依然生效ip -6 addr期望输出(只剩回环地址):
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 state UNKNOWN qlen 1000
inet6 ::1/128 scope host
valid_lft forever preferred_lft foreverping -c 3 223.5.5.5nslookup www.qq.com 127.0.0.1结果中只应出现 IPv4 地址(使用 OpenClash Fake-IP 时为 198.18.x.x),不应出现 IPv6 地址。
客户端先断开网络再重连,然后检查:
| 系统 | 命令 |
|---|---|
| Windows | ipconfig /all |
| macOS | ifconfig |
| Linux | ip -6 addr |
fe80:: 开头的地址 —— 正常(链路本地地址,系统自动生成,无法上网)240x: 或 fdxx: 开头的地址 —— IPv6 仍未关干净macOS 上utun*、awdl0、llw0等接口的fe80::地址属于系统服务(iCloud、AirDrop、VPN 等),与路由器无关,忽略即可。
| 位置 | 操作 |
|---|---|
| 网络 → 接口 | 删除 WAN6 |
| 网络 → 接口 → WAN → 高级设置 | “获取 IPv6 地址”设为 禁用 |
| 网络 → 接口 → LAN → 高级设置 | “IPv6 分配长度”设为 禁用 |
| 网络 → 接口 → 全局网络选项 | 清空 IPv6 ULA 前缀 |
| LAN → DHCP 服务器 → IPv6 设置 | RA 服务 / DHCPv6 服务 / NDP 代理 全部 禁用 |
| 网络 → DHCP/DNS → 高级设置 | 勾选 过滤 IPv6 AAAA 记录 |
| 服务 → OpenClash → 插件设置 → IPv6 设置 | 取消两个 IPv6 选项 |
| 输出 | 含义 |
|---|---|
uci: Entry not found | 要删除的配置项本来就不存在,可忽略 |
udhcpc: no lease, failing | dnsmasq 启动时检测局域网是否有其他 DHCP 服务器,没找到是正常情况 |
198.18.x.x | OpenClash / mihomo 的 Fake-IP 地址,属正常 |
# 1. 恢复内核 IPv6
sed -i '/disable_ipv6/d' /etc/sysctl.conf
sysctl -w net.ipv6.conf.all.disable_ipv6=0
sysctl -w net.ipv6.conf.default.disable_ipv6=0
# 2. 恢复接口
uci set network.wan6=interface
uci set network.wan6.device='@wan'
uci set network.wan6.proto='dhcpv6'
uci delete network.wan.ipv6
uci delete network.lan.ipv6
uci set network.lan.ip6assign='60'
uci commit network
# 3. 恢复 RA / DHCPv6
uci set dhcp.lan.ra='server'
uci set dhcp.lan.dhcpv6='server'
uci delete dhcp.lan.ndp
uci set dhcp.@dnsmasq[0].filter_aaaa='0'
uci commit dhcp
/etc/init.d/odhcpd enable
/etc/init.d/odhcpd start
# 4. 重启
reboot最后在 OpenClash 中重新勾选 IPv6 流量代理 和 允许 IPv6 类型 DNS 解析。
]]>openclash.yaml。本文基于以下环境:
| 项目 | 值 |
|---|---|
| 系统 | OpenWrt 23.05.3 |
| 架构 | x86_64 |
| 防火墙 | firewall4(nftables) |
| DNS | dnsmasq-full |
| 远程管理 | 通过 Tailscale 访问路由器 |
为什么选 OpenClash,不选 Nikki
Nikki(原 luci-app-mihomo)更轻量,但只支持 OpenWrt 24.10 及以上。在 23.05 上运行它的安装脚本会报 unsupported release: 23.05.3。如果你已经是 24.10,可以考虑 Nikki;23.05 用 OpenClash。
相比 v2ray + dnsmasq 的好处
如果你是远程登录路由器(比如通过 Tailscale),代理一旦启动出错,可能连远程连接一起断掉。每次启动、重启 OpenClash 或改它的设置之前,先在后台埋一个 5 分钟后自动停掉 OpenClash 的定时器:
pkill -f "openclash-guard" 2>/dev/null; kill $(cat /tmp/openclash-guard.pid) 2>/dev/null
(sleep 300; /etc/init.d/openclash stop; logger -t openclash-guard "auto stopped") >/dev/null 2>&1 &
echo $! > /tmp/openclash-guard.pid第一行先清掉之前没取消的定时器。如果不清,旧的定时器会在你确认一切正常之后照样到点停掉 OpenClash。
确认一切正常后,取消定时器:
kill $(cat /tmp/openclash-guard.pid) 2>/dev/null; jobsjobs 没有输出,说明后台已经没有定时器了。如果断线了,就等 5 分钟,OpenClash 会自动停掉,网络随之恢复。
opkg update && opkg install kmod-tun kmod-nft-tproxy ip-full ca-bundle curl确认 TUN 设备可用,并查看内存和存储空间:
ls /dev/net/tun && free -m && df -h /overlay内存至少 256MB,规则多的话最好 512MB 以上。存储方面,内核加规则集需要几十 MB 空间。
dnsmasq 必须是 dnsmasq-full
opkg list-installed | grep dnsmasq如果显示的是 dnsmasq-full,跳过这一步。如果只有 dnsmasq,先把 dnsmasq-full 下载到本地再替换。顺序不能反:先删掉 dnsmasq 的话,路由器自己就没法解析域名,也就下载不了新包。
cd /tmp && opkg download dnsmasq-full
opkg remove dnsmasq && opkg install /tmp/dnsmasq-full_*.ipk
[ -f /etc/config/dhcp-opkg ] && mv /etc/config/dhcp-opkg /etc/config/dhcp; /etc/init.d/dnsmasq restartOpenClash 的其余依赖:
opkg install bash coreutils-nohup libcap libcap-bin ruby ruby-yaml unzip kmod-inet-diag luci-compat两套透明代理同时运行,防火墙规则和 DNS 会互相冲突。旧方案必须先清干净。
停止服务,删除 nft 表
/etc/init.d/transparent stop; /etc/init.d/transparent disable
/etc/init.d/v2ray stop; /etc/init.d/v2ray disable
nft delete table ip v2ray 2>/dev/null删除每日更新任务
先看一眼要删的是哪一行,再删:
grep v2ray-update /etc/crontabs/root
sed -i '/v2ray-update/d' /etc/crontabs/root && /etc/init.d/cron restart清理 dnsmasq 配置
OpenClash 用 fake-ip 时,dnsmasq 会把所有查询转给 Clash。/etc/dnsmasq/ 里的下面这些文件会跟它冲突:
| 文件 | 处理 | 原因 |
|---|---|---|
proxy-gfwlist.conf、proxy-added.conf | 移走 | 里面的 nftset 指向已经删掉的 v2ray 表,分流改由 Clash 规则负责 |
apple-server.conf | 移走 | server=/apple.com/223.5.5.5 这类配置会绕过 Clash DNS |
base.conf | 删掉 all-servers 和所有 server= 行,保留 address=/*.home.marco/... | 内网域名还要靠它解析 |
reject-*.conf | 删除 | 去广告改由 Clash 的 ads 规则集负责(广告拦截 组默认 REJECT,每天自动更新);custom_reject 已包含 360 等域名。dnsmasq 的列表不会自动更新,保留只会越来越旧 |
mkdir -p /etc/dnsmasq.bak && cd /etc/dnsmasq
mv proxy-gfwlist.conf proxy-added.conf apple-server.conf reject-*.conf /etc/dnsmasq.bak/
cp base.conf /etc/dnsmasq.bak/ && sed -i '/^all-servers/d;/^server=/d' base.conf
/etc/init.d/dnsmasq restartdnsmasq 重启时可能输出 udhcpc: no lease, failing。这是启动脚本在检测局域网里有没有别的 DHCP 服务器,"no lease" 表示没有,属于正常输出。
到 GitHub 上 vernesong/OpenClash 的 Releases 页面,下载最新的 luci-app-openclash_*_all.ipk,用 scp 传到路由器的 /tmp,然后安装:
opkg install /tmp/luci-app-openclash_*_all.ipk安装结束时输出的 cfgXXXXXX 是 OpenClash 初始化 uci 配置时打印的,不是报错。装完刷新 LuCI,菜单里会出现 服务 → OpenClash。
在 服务 → OpenClash → 插件设置 → 版本更新:
| 选项 | 设置 | 说明 |
|---|---|---|
| 编译版本 | linux-amd64-v1 或 v3 | 见下方 AVX2 检查 |
| 更新分支 | Master | 默认下载 Meta alpha 内核 |
| Smart 内核 | 停用 | 见下方说明 |
选 v1 还是 v3
grep -o -w avx2 /proc/cpuinfo | head -1v3,性能会稍好一些。v1。选 v3 的话,内核根本起不来。Smart 内核是什么
Smart 内核是 OpenClash 作者维护的 mihomo 分支,多了一种 smart 策略组,会根据各节点过去的延迟、成功率等数据自动挑选节点。它适合节点很多的机场订阅。只有一个自建节点时用不上,保持停用即可。
下载失败的话,可以在同一页换一个下载地址(jsdelivr 等 CDN),或者手动上传内核安装包。
| 选项 | 设置 |
|---|---|
| 运行模式 | Fake-IP(TUN)模式,对应 uci 里的 en_mode='fake-ip-tun' |
| TUN 堆栈 | Mixed(见下表) |
| 路由本机代理 | 关闭 |
TUN 堆栈怎么选
| 堆栈 | TCP 处理 | UDP 处理 | 性能 | 兼容性 |
|---|---|---|---|---|
| System | 内核协议栈 | 内核协议栈 | 最好 | 个别环境下 UDP 有问题 |
| gVisor | 用户态协议栈 | 用户态协议栈 | CPU 和内存占用高 | 最好 |
| Mixed | 内核协议栈 | 用户态协议栈 | 接近 System | 接近 gVisor |
一般选 Mixed。游戏或语音的 UDP 不正常时换 gVisor;追求最高吞吐时试 System。
⚠️ 已知问题:在界面上保存堆栈设置时,可能被写成无效值
mips,导致 TUN 网卡起不来。每次在界面改完设置都检查一下:uci get openclash.config.stack_type如果不是
mixed,用命令行改回来:uci set openclash.config.stack_type='mixed' && uci commit openclash && /etc/init.d/openclash restart
为什么要关闭"路由本机代理"
关掉后,路由器自己的流量(tailscaled、opkg 等)不经过 Clash,只有局域网设备的流量会走代理。这样即使 OpenClash 出了问题,Tailscale 远程访问也不会断。
| 选项 | 设置 |
|---|---|
| 本地 DNS 劫持 | 开启,方式选 使用 Dnsmasq 转发 |
| 覆写设置 → 自定义上游 DNS 服务器 | 不要启用,否则配置文件里 dns 段的上游会被替换掉 |
| 覆写设置 → DNS → respect-rules(遵循规则) | 开启。OpenClash 会按这个开关改写配置文件里的 respect-rules,默认写成 false |
为什么必须开启 respect-rules
respect-rules: false 时,nameserver 里的 Cloudflare、Google DoH 会从路由器直连,在国内基本连不上。普通国外域名拿的是 fake-ip,真正的解析在代理服务器上完成,所以看不出问题;但 fake-ip-filter 里又不在国内规则集里的域名(比如 time.google.com)只能靠这两个 DoH,会全部返回空结果(No answer)。
开关的 uci 名称可以这样查,启动后再确认生效值:
uci show openclash | grep -i respect
grep -n "respect-rules" /etc/openclash/openclash.yaml # 应为 trueopenclash.yaml 的分流全部用 .mrs 规则集,没有 GEOIP、GEOSITE、IP-ASN 规则,所以用不到 GEO 数据库。在 插件设置 → GEO 数据库订阅 里,把 GeoIP、GeoSite、GeoIP Dat、GeoASN 的自动更新都关掉。
这些任务不要去 crontab 里手动删。带 #openclash-cron-task 标记的行由 OpenClash 自己管理,保存或重启时会重新写回去。
以 openclash.yaml 为基础,把节点信息里的占位符换成你自己的:
| 占位符 | 替换为 |
|---|---|
111.111.111.111 | 服务器地址或域名 |
uuid-uuid-uuid-uuid | UUID |
xxx.com | TLS SNI 和 WebSocket 的 Host |
/path | WebSocket 路径,与服务端、nginx 保持一致 |
在 配置文件管理 上传这个文件。上传后它存放在 /etc/openclash/config/ 下。
tun 段、DNS 监听、enhanced-mode、fake-ip-range:这些由 OpenClash 界面管理,启动时会覆盖,配置文件里不用写。off、on、yes、no 会被当成布尔值,所以必须加引号,比如 find-process-mode: "off"。不加引号的话,内核会报 invalid find process mode。path 统一改到 ./rule_provider/,实际文件位于 /etc/openclash/rule_provider/。*.home.marco 内网域名:
fake-ip-filter 里,所以返回真实 IP,不会被分配假地址;nameserver-policy 把它交给本机的 dnsmasq(127.0.0.1)解析;skip-domain 也包含它,避免直连时拿域名去国内 DNS 解析而失败。niekun.net:直连,并且在 fake-ip-filter 里需要真实解析,所以在 nameserver-policy 里单独交给国内 DoH,不依赖经代理的国外 DoH。100.64.0.0/10、fd7a:115c:a1e0::/48、192.168.x.x 都在 private_ip 规则集里,这是第一条规则,全部直连。NETWORK,UDP,DIRECT。geolocation-!cn、cn 等规则集里,避免重复。先埋好回滚定时器,然后在 LuCI 的 运行状态 页点"启动",或者执行:
/etc/init.d/openclash start启动日志里出现"OpenClash 启动成功"就可以开始验证。
1. 远程连接
新开一个 SSH 或 LuCI 会话(用 Tailscale 地址或 openwrt.home.marco),确认还能连上。
2. DNS
nslookup nas.home.marco 127.0.0.1; nslookup google.com 127.0.0.1; nslookup baidu.com 127.0.0.1| 域名 | 预期结果 |
|---|---|
nas.home.marco | 192.168.122.5,真实内网 IP |
google.com | 198.18.x.x,fake-ip 生效 |
baidu.com | 198.18.x.x 也正常,连接时会被 cn_domain 规则匹配后直连 |
3. 进程、TUN、堆栈
pgrep -af clash | head -3
ip addr show utun | grep inet
grep -A2 "^tun:" /etc/openclash/*.yaml正常的话会看到:
/etc/openclash/clash -d /etc/openclash ... 和守护进程 openclash_watchdog.sh;inet 198.18.0.1/30;stack: mixed。4. 规则集
ls -la /etc/openclash/rule_provider/
grep -iE "provider|rule-set" /tmp/openclash.log | tail目录里应该有 19 个 .mrs 文件(inline 规则集不生成文件),日志里没有报错。规则集是通过 节点选择 下载的,能下载下来也说明节点是通的。
5. 分流
在局域网设备上分别打开 google.com、chatgpt.com、baidu.com,然后在控制面板的"连接"页核对它们走的策略组:
| 网站 | 预期策略组 |
|---|---|
| google.com | 节点选择 |
| chatgpt.com | AI 服务 |
| baidu.com | DIRECT |
全部正常后,取消回滚定时器。
开机自启
ls /etc/rc.d/ | grep -i openclash; uci get openclash.config.enable需要看到 S99openclash、K15openclash 和 1。缺哪项就补上:
/etc/init.d/openclash enable; uci set openclash.config.enable='1'; uci commit openclash确认旧方案不会开机启动:
ls /etc/rc.d/ | grep -iE "v2ray|transparent"这条应该没有输出。
找个方便的时间运行一次 reboot 实测。1~2 分钟后连回来,确认 pgrep -af clash 和 utun 都正常。
每周定时重启(可选)
每周一凌晨 1 点重启,排在 OpenClash 周一 0 点的 GEO 更新之后:
sed -i 's|^0 1 \* \* \* /sbin/reboot|0 1 * * 1 /sbin/reboot|' /etc/crontabs/root && /etc/init.d/cron restart
crontab -l第 5 个字段是星期几:0 是周日,1 是周一,依此类推。cron 用的是路由器本地时区,可以检查一下:
uci get system.@system[0].zonename; date正常应该显示 Asia/Shanghai,date 的时间也应该和本地一致。
/etc/sysupgrade.conf 里列出的文件,会在系统升级或用 LuCI 备份时保留。/etc/config/openclash 在 /etc/config/ 下,系统默认就会保留,但上传的配置文件和自定义规则要手动加进来。core/ 和 rule_provider/ 能重新下载,不用备份。
cat > /etc/sysupgrade.conf <<'EOF'
## This file contains files and directories that should
## be preserved during an upgrade.
# 系统
/etc/crontabs/
/etc/ethers
/etc/installed_packages.txt
# dnsmasq(base.conf 内网域名;.bak 是旧 v2ray 代理列表)
/etc/dnsmasq/
/etc/dnsmasq.bak/
/etc/dnsmasq.conf
# OpenClash(/etc/config/openclash 默认已保留;core、rule_provider 可重新下载,不备份)
/etc/openclash/config/
/etc/openclash/custom/
# 旧 v2ray 方案,留作回滚;OpenClash 稳定运行一段时间后可删除这几行
/etc/init.d/transparent
/etc/init.d/v2ray
/etc/v2ray/
EOF检查实际会备份哪些文件:
sysupgrade -l | grep -E "openclash|dnsmasq|v2ray|crontabs"OpenClash 自带 MetaCubeXD 等控制面板,可以切换规则、全局、直连模式,选节点,查看连接和日志。
面板上改的设置只对当前运行有效。 面板是通过 API 直接改正在运行的内核,不会写回 OpenClash。OpenClash 一重启(开机、更新规则、在 LuCI 里点"应用"),就会按 uci 设置重新生成配置,面板上的改动会被覆盖。
openclash.yaml。GLOBAL 组只在全局模式下起作用,规则模式下选什么都不影响分流。全局模式会把内网和 Tailscale 的流量也送进代理,只建议临时排查问题时用。
| 现象 | 原因 | 处理 |
|---|---|---|
Nikki 安装脚本报 unsupported release: 23.05.3 | Nikki 只支持 24.10 及以上 | 改用 OpenClash,或者先升级系统 |
内核日志报 Parse config error: invalid find process mode | 不加引号的 off 被 Ruby 改写成了 false | 改成 find-process-mode: "off" |
界面上的"TUN 转发"自动关闭,utun 不存在 | stack_type 被保存成了 mips | 用 uci set openclash.config.stack_type='mixed' 改回,然后重启 |
/etc/openclash/ruleset/ 目录不存在 | OpenClash 把路径改成了 rule_provider/ | 去 /etc/openclash/rule_provider/ 下看 |
rule_provider/ 是空的 | 节点不通,规则集经代理下载失败 | 检查节点配置,看 /tmp/openclash.log |
*.home.marco 返回 198.18.x.x | fake-ip-filter 没生效 | 在 覆写设置 → DNS → Fake-IP-Filter 里再加一遍 |
niekun.net、time.google.com 等 fake-ip-filter 里的域名 nslookup 返回 No answer,网站打不开 | OpenClash 把 respect-rules 改写成了 false,国外 DoH 被直连而失败 | 在界面开启 respect-rules(见 7.2),重启后用 nslookup -port=7874 time.google.com 127.0.0.1 验证 |
| OpenClash 莫名其妙停了 | 之前的回滚定时器没取消,到点执行了 stop | 先清掉旧定时器再埋新的(见第 2 节);守护进程通常会自动把内核拉起来 |
| 游戏或语音的 UDP 不正常 | 堆栈兼容性问题 | 把 TUN 堆栈换成 gVisor 试试 |
| Tailscale 远程连接断开 | 开了路由本机代理,或者用了全局模式 | 关闭路由本机代理,切回规则模式 |
常用日志:
tail -50 /tmp/openclash.log
logread | grep -iE "openclash|openclash-guard" | tail -30/etc/init.d/openclash stop; /etc/init.d/openclash disable; uci set openclash.config.enable='0'; uci commit openclash
mv /etc/dnsmasq/base.conf /etc/dnsmasq/base.conf.openclash
cp /etc/dnsmasq.bak/* /etc/dnsmasq/
/etc/init.d/dnsmasq restart
/etc/init.d/v2ray enable; /etc/init.d/v2ray start
/etc/init.d/transparent enable; /etc/init.d/transparent start
echo '0 5 * * * sh /etc/v2ray/script/v2ray-update.sh update 2>&1 | logger -t v2ray-update' >> /etc/crontabs/root && /etc/init.d/cron restart/etc/dnsmasq.bak/ 里存着原来的 base.conf 和三个代理列表,复制回去就恢复了原来的 DNS 分流。
docker compose pull && docker compose up -d
可以通过在 compose 文件中设置 watchtower 来定期自动拉取最新镜像并启动容器,同时可以配置删除旧镜像和容器。
在 docker-compose.yml 文件中增加以下内容:
version: '3'
services:
...
watchtower:
image: containrrr/watchtower
volumes:
- /var/run/docker.sock:/var/run/docker.sock
command: --interval 3600 --cleanup --remove-volumes
environment:
- WATCHTOWER_CLEANUP=true
- WATCHTOWER_REMOVE_VOLUMES=true以下是主要的配置说明:
--interval 参数设置为 3600。这意味着 Watchtower 将每 3600 秒(即每小时)检查一次更新。--cleanup 和 WATCHTOWER_CLEANUP=true 确保在更新后清理旧的镜像。--remove-volumes 和 WATCHTOWER_REMOVE_VOLUMES=true 确保删除与旧容器关联的匿名卷。使用这个配置,Watchtower 将:
这个配置应该能满足大多数用例的需求,既能保持你的容器相对最新,又不会过于频繁地进行检查和更新操作。
需要注意的是:
docker image prune 命令。核心就是通过 alias 关联文件路径。
配置文件如下:
location /test.log {
alias /home/script/igd/app.log;
default_type text/plain;
add_header Content-Type "text/plain; charset=utf-8";
charset utf-8;
# 确保不会缓存内容
add_header Cache-Control "no-cache, no-store, must-revalidate";
add_header Pragma "no-cache";
add_header Expires "0";
}location 路径替换为需要的路径。alias 设置文件实际路径。
]]>Something went wrong. You may be connected to a disallowed ISP If youare using VPN, try disabling it. Otherwise try a different Wi-Fi network or data connection。
经过查询发现是我的 vps 服务商只提供网页端 chatgpt 解锁,不支持 app 端。由于 chatgpt 服务也是通过 cloudflare 的 cdn 服务,所以通过将流量转发到 warp 来访问就可以解决问题。
首先需要在服务端安装官方的 warp 命令行工具:warp-cli。
官方教程:https://developers.cloudflare.com/warp-client/get-started/linux/
官方手动添加包仓库教程:https://pkg.cloudflareclient.com/#ubuntu
在命令行输入以下指令来安装第三方仓库并安装包:
# Add cloudflare gpg key
curl -fsSL https://pkg.cloudflareclient.com/pubkey.gpg | sudo gpg --yes --dearmor --output /usr/share/keyrings/cloudflare-warp-archive-keyring.gpg
# Add this repo to your apt repositories
echo "deb [signed-by=/usr/share/keyrings/cloudflare-warp-archive-keyring.gpg] https://pkg.cloudflareclient.com/ $(lsb_release -cs) main" | sudo tee /etc/apt/sources.list.d/cloudflare-client.list
# Install
sudo apt-get update && sudo apt-get install cloudflare-warp安装好后需要注册一个新账户:
warp-cli registration new
查看当前账户信息:
warp-cli registration show
更换新的 license:
warp-cli registration license xxxxx-xxxxxx-xxxxxx
然后需要设置代理模式,可选有:warp, doh, warp+doh, dot, warp+dot, proxy, tunnel_only。
我只想要它提供一个 socks5 代理端口即可,所以设置为 proxy 模式,它会在本地 40000 端口监听:
warp-cli mode proxy
启动 warp:
warp-cli connect
此时 warp 会在本地 40000 端口建立一个 sock5 代理,只需要将需要转发的流量转发到此端口即可走 warp。并且 warp 会自动配置为 Always On 模式,开机自动运行代理。
查看 warp 当前配置:
# warp-cli settings
Merged configuration:
(derived) Always On: true
(default) Switch Locked: false
(user set) Mode: WarpProxy on port 40000
(Not set) WARP tunnel protocol: MASQUE
(default) Disabled for Wifi: false
(default) Disabled for Ethernet: false
(Not set) Resolve via: cloudflare-dns.com @ [162.159.36.1, 2606:4700:4700::1111]
(Not set) qlog logging: Disabled
(default) Onboarding: true
(API defaults) Exclude mode, with hosts/ips:
10.0.0.0/8
100.64.0.0/10
169.254.0.0/16
172.16.0.0/12
192.0.0.0/24
192.168.0.0/16
224.0.0.0/24
240.0.0.0/4
239.255.255.250/32
255.255.255.255/32
fe80::/10
fd00::/8
ff01::/16
ff02::/16
ff03::/16
ff04::/16
ff05::/16
fc00::/7
(default) Fallback domains:
intranet
internal
private
localdomain
domain
lan
home
host
corp
local
localhost
home.arpa
invalid
test
(Not set) Daemon Teams Auth: false
(default) Disable Auto Fallback: false
(Not set) Allow Updates: true查看代理是否生效:
export ALL_PROXY=socks5://127.0.0.1:40000
curl ifconfig.me服务端的配置文件需要添加和修改的地方如下:
{
"outbounds": [
...
{
"protocol": "socks",
"settings": {
"address": "127.0.0.1",
"port": 40000
},
"tag":"socks_out"
}
],
"router": {
"domainStrategy": "AsIs",
"rule": [
...
{
"tag": "socks_out",
"geoDomain": [
{
"code": "openai",
"filePath": "geosite.dat"
}
],
"domainMatcher": "mph"
}
]
},
"inbounds": [
{
"protocol": "vmess",
...
"sniffing": {
"enabled": true,
"destOverride": [
"http",
"tls"
]
},
...注意需要安装扩展版的 geosite.dat 才有 openai 的条目:https://github.com/Loyalsoldier/v2ray-rules-dat
通过访问以下网址测试是否已经解锁 ios app 端:https://ios.chat.openai.com/public-api/mobile/server_status/v1
以上就是解决 chatgpt 无法访问的方法。
]]>quic 协议走的是 udp 层,一般是 443 或 80 端口。
openwrt 或其他 linux 系统上使用 nftables 设置规则即可:
新建路由表
nft add table ip tabletest
# 局域网流量屏蔽
# 局域网流量目标地址是外部地址时传输路径为 prerouting -> forward -> postrouting hooks
nft add chain ip tabletest prerouting { type nat hook prerouting priority 0 \; policy accept \; }
nft add rule ip tabletest prerouting udp dport { 80, 443 } drop
# 本机网关流量屏蔽
# 本机网关流量目标地址时外部地址时传输路径为 本机 -> output -> postrouting hooks
nft add chain ip tabletest output { type nat hook output priority 0 \; policy accept \; }
nft add rule ip tabletest output udp dport { 80, 443 } drop在 Chrome 中禁用 HTTP/3:
在 Firefox 中禁用 HTTP/3:
# 清华源
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
# 阿里源
pip config set global.index-url https://mirrors.aliyun.com/pypi/simple/
# 腾讯源
pip config set global.index-url http://mirrors.cloud.tencent.com/pypi/simple
# 豆瓣源
pip config set global.index-url http://pypi.douban.com/simple/
# 换回默认源
pip config unset global.index-url
]]>路由表是 nftables 中最顶层的容器,它管理着 chains, sets, maps, flowtables, 和 stateful objects.
每个路由表都只能属于一个 family 集合,可用的 family 有:
新建路由表:
nft add table ip tabletest
以上命令在 ip 集合中新建一个名称为 tabletest 的路由表,可以处理 ipv4 流量
路由表列表:
# 列出所有路由表
nft list tables
# 列出所有 ip 集合的路由表
nft list tables ip删除一个路由表:
nft delete table ip tabletest
不同于 iptables,nftables 没有预定义的链,如 input output 等。想要在某个环节处理流量,需要定义一个自定义名称的基本链,然后将其挂载在一个特定的 netfilter hook 钩子上。下图是流量包在 linux 网络中的传输路径:
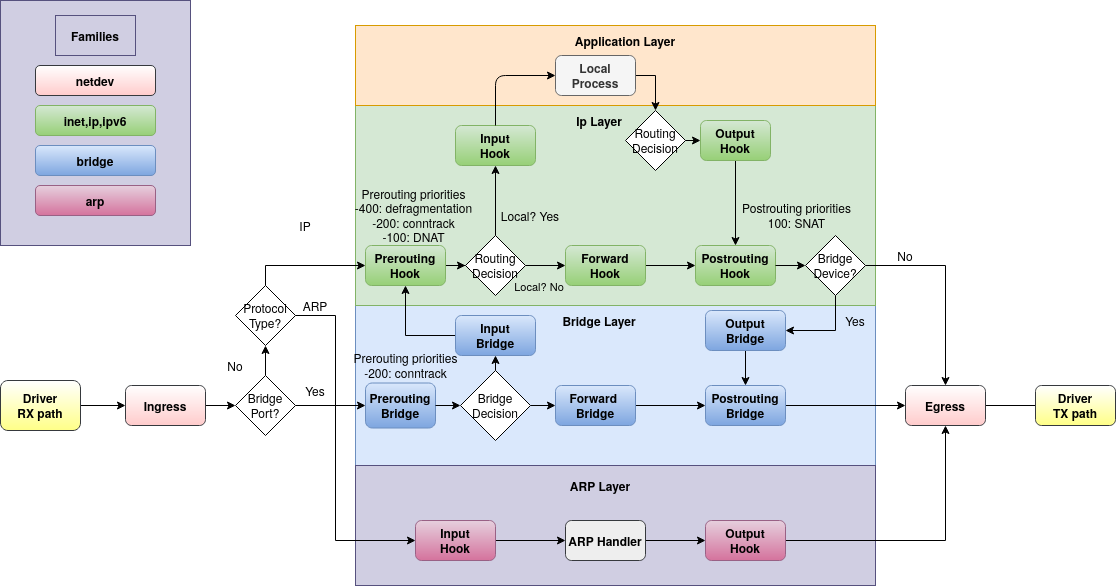
外部访问流量传输到本机后如果目标地址是本机,流量传输路径是 prerouting -> input hooks -> 本机,然后经过本机处理后流向 本机 -> output -> postrouting hooks。
如果传入本机的外部流量目标地址不是本机,则受 forward hook 监听,这类流量的传输路径是 prerouting -> forward -> postrouting。
本机访问外部地址的流量传输路径是 本机 -> output -> postrouting hooks。
注意如果本机作为 router 路由使用,需要提前开启 ip 转发功能:
echo 1 > /proc/sys/net/ipv4/ip_forward
以下是 netfilter 可用的 chains 和 hooks 列表:
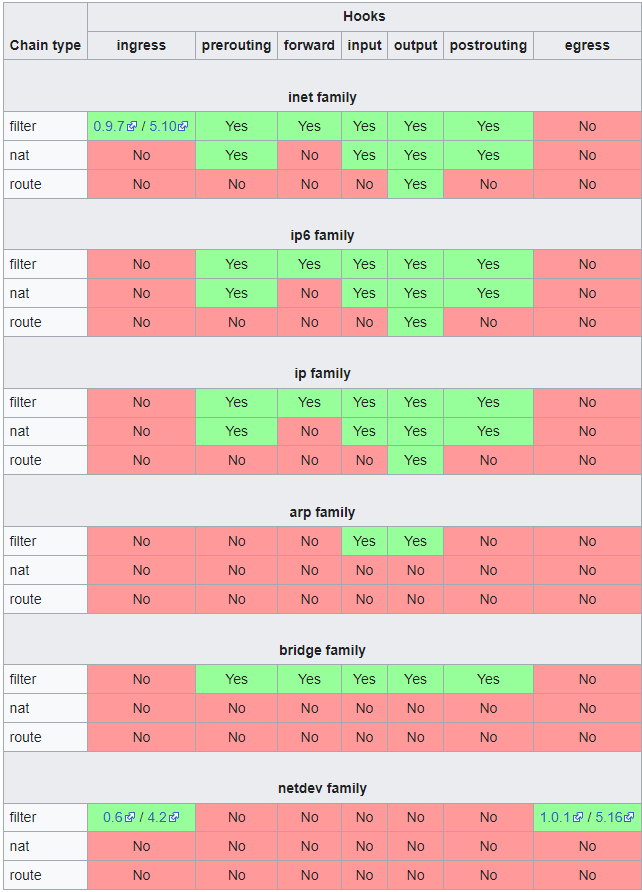
建立基本链,挂载在一个特定 type 的 netfilter hook:
nft add chain [<family>] <table_name> <chain_name> { type <type> hook <hook> priority <value> \; [policy <policy> \;] [comment \"text comment\" \;] }
注意,由于 nft 语法使用了特殊字符,如: ;,在命令行中执行需要加转义符 \。或者可以使用单引号 '` 将 nft 后的语句包起来,以下两种写法效果相同:
nft add chain ip tabletest input { type filter hook input priority 0 \; }
nft 'add chain ip tabletest input { type filter hook input priority 0 ; }'
另一种方法是运行 nft 在交互模式,执行以下命令后就可以不加转义符: nft -i。
上面的命令在 tebletest 路由表中新建一个 input 链,挂载在 filter 路由链的 input hook 上。这样就可以监听所有进入本地的流量。
priority 决定了所有链的顺序,例如在 filter input hook 上挂载了多个自定义链,通过 priority 决定其执行顺序。数值越低执行优先级越高,例如 -12, -1, 0, 10。如果给多个挂载在同一个 hook 上的自定义基本链同样的 priority,它们的先后执行顺序就是不确定的。
添加以下命令后就可以在 tabletest 基本链中监听本机输出的流量:
nft 'add chain ip tabletest output { type filter hook output priority 0 ; }'
如果不定义大括号中的内容,也就是不挂载在特定 hook 上,则路由链不会监听任何流量。
policy 定义了默认的策略,可用的默认策略为:accept 和 drop,如果路由链中的规则都没有匹配则会应用默认策略:
type 指定自定义路由链挂载到那个基本 chain,可用的基本链:
hook 定义了挂载的基本链 hook,可用的 hooks 如下:
列出一个路由表的所有路由链:
nft list ip table tabletest
列出一个路由表的指定路由链:
nft list chain ip tabletest output
comment 可以给规则添加注释:
nft add rule ip tabletest input counter comment \"test comment\"
通过规则可以控制路由链上的流量。
添加规则:
nft add rule ip tabletest output ip daddr 8.8.8.8 counter
以上命令会在 tabletest 路由表的 output 链中添加一条规则,匹配出口流量中 ip 地址为 8.8.8.8 的流量并对匹配次数计数,nftables 中 counter 会默认启用即使不写。以上命令相当于 iptables 中的 -A 命令。
列出某个链包含的规则:
root@OpenWrt:~# nft list chain ip tabletest output
table ip tabletest {
chain output {
type filter hook output priority filter; policy accept;
ip daddr 8.8.8.8 counter packets 0 bytes 0
}
}下面测试以上规则是否生效,执行以下命令:
ping -c 1 8.8.8.8再次查看此链的规则:
root@OpenWrt:~# nft list chain ip tabletest output
table ip tabletest {
chain output {
type filter hook output priority filter; policy accept;
ip daddr 8.8.8.8 counter packets 1 bytes 84
}
}可以看到已经有一次计数了。
指定位置添加规则:
nftables 中必须通过 handle num 编号来在指定位置添加规则,需要通过 -a 查看链中已经存在的规则的编号:
nft -n -a list table ip tabletest
-n 可以按数字顺序排号避免出现重复编号。再次查看链中的规则:
root@OpenWrt:~# nft -n -a list table ip tabletest
table ip tabletest { # handle 4
chain output { # handle 1
type filter hook output priority 0; policy accept;
ip daddr 8.8.8.8 counter packets 0 bytes 0 # handle 5
}
}handle 5 就是这条规则的编号。
下面我们通过 handle 索引在这条规则后添加一条新规则:
nft add rule ip tabletest output position 5 ip daddr 127.0.0.8 drop
查看链中的规则:
root@OpenWrt:~# nft -n -a list table ip tabletest
table ip tabletest { # handle 4
chain output { # handle 1
type filter hook output priority 0; policy accept;
ip daddr 8.8.8.8 counter packets 0 bytes 0 # handle 5
ip daddr 127.0.0.8 drop # handle 6
}
}如果要在某条规则前插入一条规则需要使用 insert 指令:
nft insert rule ip tabletest output position 5 ip daddr 127.1.1.8 drop
查看效果:
root@OpenWrt:~# nft -n -a list table ip tabletest
table ip tabletest { # handle 4
chain output { # handle 1
type filter hook output priority 0; policy accept;
ip daddr 127.1.1.8 drop # handle 7
ip daddr 8.8.8.8 counter packets 0 bytes 0 # handle 5
ip daddr 127.0.0.8 drop # handle 6
}
}在某条链最前面添加一条规则:
nft insert rule ip tabletest output ip daddr 192.168.2.1 counter
在最前面添加规则就不需要指定 handle 了。
替换某条规则:
替换一条规则也需要 handle 编号。下面示例会替换 handle 5 为新的规则:
nft replace rule ip tabletest output handle 5 ip daddr 1.1.1.1
删除规则:
同样的,删除某一条规则也需要获取这条规则的 handle 编号。
删除 tabletest 链的 handle 7 规则:
nft delete rule ip tabletest output handle 7
删除链中所有规则:
nft flush chain ip tabletest output
删除路由表中所有链的所有规则:
nft flush table ip tabletest
显示所有 family 的所有 rule 规则:
nft list ruleset
显示某一个集合的所有 rule:
% nft list ruleset arp
% nft list ruleset ip
% nft list ruleset ip6
% nft list ruleset bridge
% nft list ruleset inet清除所有集合的所有规则:
nft flush ruleset
清除某一个集合的所有规则:
% nft flush ruleset arp
% nft flush ruleset ip
% nft flush ruleset ip6
% nft flush ruleset bridge
% nft flush ruleset inet备份规则到文件:
# 备份所有集合的所有规则
nft list ruleset >> backup.nft
# 备份 ip 集合的所有规则
nft list ruleset ip >> backup.nft从文件恢复规则:
nft -f backup.nft
以 json 格式显示所有规则:
nft --json list ruleset
通过 meta 选择器可以进行流量匹配或流量设置。下面简单介绍几个常用的匹配模式,更加详细的参考官方资料:https://wiki.nftables.org/wiki-nftables/index.php/Matching_packet_metainformation
iifname 匹配网卡名称:
# lo 网卡的入口流量会被接收
nft add rule tabletest input meta iifname lo acceptmark 匹配流量标记:
# 流量标记为 123 的出口流量计数
nft add rule tabletest output meta mark 123 counterskgid 匹配流量由特定 gid 用户产生的数据:
# 匹配来自 gid 用户 1000 的流量
nft add rule tabletest output meta skgid 1000 counter通过 ip {saddr | daddr} 可以匹配 ipv4 的源流量或目标流量:
# 匹配来自 192.168.1.100 且去往 192.168.1.1 的流量并计数
# 注意本机地址必须为 192.168.1.1 才可以由 input hook 截获
nft add rule ip tabletest input ip saddr 192.168.1.100 ip daddr 192.168.1.1 counter通过 icmp type 关键词来匹配 icmp 流量,如 ping request:
nft add rule ip tabletest input icmp type echo-request counter drop
可以通过命令查询所有可用的 icmp type 类型:
root@OpenWrt:~# nft describe icmp type
payload expression, datatype icmp_type (ICMP type) (basetype integer), 8 bits
pre-defined symbolic constants (in decimal):
echo-reply 0
destination-unreachable 3
source-quench 4
redirect 5
echo-request 8
router-advertisement 9
router-solicitation 10
time-exceeded 11
parameter-problem 12
timestamp-request 13
timestamp-reply 14
info-request 15
info-reply 16
address-mask-request 17
address-mask-reply 18通过 ip protocol 匹配 ip family 任意类型的协议:
# 匹配所有 tcp 流量
nft add rule ip tabletest output ip protocol tcp
# 匹配所有 tcp udp 流量
nft add rule ip tabletest output ip protocol { tcp, udp }通过 meta l4proto 匹配 inet family 任意类型的协议:
# tabletest 需要定义为 inet 集合
nft add rule inet tabletest output meta l4proto tcp匹配特定端口的流量:
# 丢弃所有端口为 1-1024 的 tcp 流量访问本机
nft add rule ip tabletest input tcp dport 1-1024 counter dropdrop 可以对匹配的流量直接丢弃,注意 drop 不能和其他动作组合使用:
nft add rule ip tabletest input ip protocol udp drop
accept 可以对匹配的流量接收,可以和其他动作组合使用 如 counter 计数:
nft add rule ip tabletest input counter accept
不同于 drop,reject 可以在拒绝流量的基础上进行很多其他动作,如返回给源请求地址无法访问的原因等。如果不指定其他动作,默认会返回源地址一个 ICMP/ICMPv6 port unreachable 的流量包。
示例如下:
# 拒绝所有 input 的 udp 流量
nft add rule ip tabletest input ip protocol udp reject
# 拒绝指定流量并返回 icmp host-unreachable
nft add rule ip tabletest input reject with icmp type host-unreachableicmp 可用如下原因:
net-unreachable: Destination network unreachable
host-unreachable: Destination host unreachable
prot-unreachable: Destination protocol unreachable
port-unreachable: Destination port unreachable (this is the default)
net-prohibited: Network administratively prohibited
host-prohibited: Host administratively prohibited
admin-prohibited: Communication administratively prohibited注意只能跳转到同一个路由表的其他 chain。
首先我们新建一个 chain:
nft add chain ip tabletest tcp-chain
然后定义这个链的规则:
nft add rule ip tabletest tcp-chain counter
然后可以定义将所有匹配的流量跳转过去:
ft add rule ip tabletest input ip protocol tcp jump tcp-chain
以上示例实现的就是将所有 input 的 tcp 流量跳转到 tcp-chain 计数,然后就返回原始 input 环节继续流转。
通过 log 可以记录匹配到的流量信息,在系统日志中可以查看到。
下面是一个示例,可以记录所有对本机的 ping 请求:
nft add rule ip tabletest input icmp type echo-request log prefix \"New ping request: \" accept从局域网对本机进行 ping 后,系统日志如下:
Thu May 9 11:58:04 2024 kern.warn kernel: [ 3741.786865] New ping request: IN=br-lan OUT= MAC=00:0c:29:c5:39:8d:00:50:56:c0:00:02:08:00 SRC=192.168.244.2 DST=192.168.244.1 LEN=60 TOS=0x00 PREC=0x00 TTL=128 ID=49655 PROTO=ICMP TYPE=8 CODE=0 ID=1 SEQ=6609nat 链类型可以执行网络地址转换的功能,这种链类型有其特有的属性:
先定义一个 nat 类型的基本链:
nft add chain ip tabletest postrouting { type nat hook postrouting priority 0 \; }
以上定义了一个 nat 类型的基本链挂载在 postrouting hook 上。
snat 表示源地址。
下面的规则可以将来自 192.168.1.0/24 从 eth0 网卡发出的流量在发送出去的时候,将源地址修改为 1.2.3.4
nft add rule ip tabletest postrouting ip saddr 192.168.1.0/24 oif eth0 snat to 1.2.3.4
也可以定义一个地址范围:
# 将所有 tcp 流量的源地址都修改为指定的ip范围内
nft add rule ip tabletest postrouting ip protocol tcp snat ip to 10.0.0.1-10.0.0.100:3000-4000下面介绍如何修改目标地址,再定义一个 nat 类型的基本链:
nft add chain ip tabletest prerouting { type nat hook prerouting priority 0 \; }
以上定义了一个 nat 类型的基本链挂载在 prerouting hook 上。
dnat 表示目标地址。
下面规则会将要进入 eth0 的 tcp 80 443 端口的流量的目标地址改为 192.168.1.120 也就是重定向:
nft 'add rule ip tabletest prerouting iif eth0 tcp dport { 80, 443 } dnat to 192.168.1.120'
redirect 是一种特殊的 dnat,它会将流量重定向到本机设备上:
nft add rule ip tabletest prerouting tcp dport 22 redirect to 2222
以上规则会将进入的 tcp 22 端口的流量转发到本机 2222端口上。
需要注意的是 redirect 只能应用于 nat 链类型的 prerouting 和 output hooks。
设置 mark 标记:
nft add rule ip tabletest output mark set 123
nftables 提供了 set 架构可以用任意支持的选择器来搭建 sets。
匿名 set 是直接定义在 rule 内的 set,它没有特定的名称,也不可以更新 set 中的元素,下面是一个示例:
nft add rule ip tabletest output tcp dport { 22, 23 } counter
{ 22, 23 } 就属于一个匿名 set。规则会去尝试匹配 set 中的每个元素。
可以通过 nft add set 来创建一个有名称的 set,例如:
nft add set ip tabletest blackhole { type ipv4_addr \; comment \"drop all packets from these hosts\" \; }
blackhole 就是这个 set 的名称,后续可以再 rule 中使用。set 类型指定是 ipv4 数据。set 名称需要小于等于16个字符,comment 注释是可选项。
可用的 type 类型有:
ipv4_addr: IPv4 address
ipv6_addr: IPv6 address.
ether_addr: Ethernet address.
inet_proto: Inet protocol type.
inet_service: Internet service (read tcp port for example)
mark: Mark type.
ifname: Network interface name (eth0, eth1..)
建立好之后就可以往 set 里添加元素了:
nft add element ip tabletest blackhole { 192.168.3.4 }
nft add element ip tabletest blackhole { 192.168.1.4, 192.168.1.5 }如果要添加一个 ip 网段则需要将 set 定义 flags interval:
nft add set ip tabletest blackhole { type ipv4_addr \; flags interval \; }
然后就可以添加一个 ip 网段了:
nft add element ip tabletest blackhole { 192.168.1.0/24 }
可以查询 set 中现有的元素:
root@OpenWrt:~# nft list set ip tabletest blackhole
table ip tabletest {
set blackhole {
type ipv4_addr
comment "drop all packets from these hosts"
elements = { 192.168.1.4, 192.168.1.5,
192.168.3.4 }
}
}下面就可以通过 set 名称在 nftables 规则中应用:
nft add rule ip tabletest input ip saddr @blackhole drop
nft add rule ip tabletest output ip daddr != @blackhole accept以上就是 natables 的基本用法。
nftables HOWTO documentation page
Nftables families
Netfilter hooks
Operations at ruleset level
下面介绍如何通过 nfset 和 nftables 实现同样的功能。
首先查看 dnsmasq 版本是否支持 nftset:
root@OpenWrt:~# dnsmasq -v
Dnsmasq version 2.90 Copyright (c) 2000-2024 Simon Kelley
Compile time options: IPv6 GNU-getopt no-DBus UBus no-i18n no-IDN DHCP DHCPv6 no-Lua TFTP conntrack no-ipset nftset auth cryptohash DNSSEC no-ID loop-detect inotify dumpfile可以看到其中有 nftset 字样,如果没有就需要安装 dnsmasq-full,安装教程参考:dnsmasq 使用教程。
nftables 提供 set 功能可以在一个路由表中建立特定名称一个 ip 库,并通过命令 ip daddr 索引库里的地址。关于 nftables 的使用教程参考:nftables 使用教程
先建立一个任意名称的路由表:
nft add table tabletest
然后给这个路由表建立一个名称为 iplist 的 ip 库,类型定义为 ipv4 地址:
nft add set ip tabletest iplist { type ipv4_addr\; }
如果要添加一个 ip 网段,必须定义 ip 库属性:flags interval
nft add set ip tabletest iplist { type ipv4_addr \; flags interval \; }
现在就可以给这个 ip 库里添加 ip 地址了,命令如下:
nft add element ip tabletest iplist { 111.22.33.4 };
nft add element ip tabletest iplist { 111.22.33.4/16 };
可以通过命令查看这个 ip 库里包含的所有地址:
root@OpenWrt:~# nft list set ip tabletest iplist
table ip tabletest {
set iplist {
type ipv4_addr
flags interval
elements = { 111.22.33.4, 111.22.33.4/16 }
}
}通过 dnsmasq 配置文件也可以添加指定域名解析出的 ip 地址到 nftset 对应 ip 库列表中,例如在 /etc/dnsmasq.conf 配置文件中添加以下指令:
nftset=/qq.com/4#ip#tabletest#iplist
重启 dnsmasq 服务:
service dnsmasq restart
查询一下 qq.com 的 ip 地址:
root@OpenWrt:~# nslookup qq.com
Server: 127.0.0.1
Address: 127.0.0.1:53
Non-authoritative answer:
Name: qq.com
Address: 157.255.219.143再次查看 iplist 表里包含的 ip 地址:
root@OpenWrt:~# nft list set ip tabletest iplist
table ip tabletest {
set iplist {
type ipv4_addr
flags interval
elements = { 111.22.33.4, 111.22.33.4/16, 157.255.219.143 }
}
}可以看到 qq.com 解析出来的 ip 地址已经放入了 iplist 表中。
nftables 可以识别并处理 nftset 表中的 ip 地址,这样就可以做到对指定域名的流量控制。
新建的自定义路由表需要首先指定某个动作链条属于什么动作链类型。如:
# 定义 tabletest 的 output 链,类型为 filter 路由链的动作链 "output"
# 优先级 0 表示:(在任何路由决策前捕获传入数据包)
# 策略为 accept 表示没有匹配流量后继续传入后续路由表及规则进行匹配
nft add chain tabletest output { type filter hook output priority 0 \; policy accept \; }
# 定义 tabletest 的 prerouting 链,类型为 NAT 路由链的动作链 "prerouting"
nft add chain tabletest prerouting { type nat hook prerouting priority 0 \; policy accept \; }nftables 规则处理 set 库里 ip 地址的流量:
# 屏蔽本机对 iplist 库中 ip 地址的访问
nft add rule tabletest output ip daddr @iplist drop
# 目标地址为 set 库地址的prerouting tcp 流量转发到指定端口
nft add rule tabletest prerouting ip daddr @iplist ip protocol tcp redirect to :1081列出指定路由表定义的规则:
root@OpenWrt:~# nft list table tabletest
table ip tabletest {
set iplist {
type ipv4_addr
flags interval
elements = { 111.22.33.4, 111.22.33.4/16, 157.255.219.143 }
}
chain output {
type filter hook output priority filter; policy accept;
ip daddr @iplist drop
}
chain prerouting {
type nat hook prerouting priority filter; policy accept;
ip daddr @iplist ip protocol tcp redirect to :1081
}
}删除一个路由表:
nft delete table tabletest
删除一个路由表中所有规则,保留路由链定义:
nft flush table tabletest
删除指定路由表中某个路由链中的所有规则:
nft flush chain tabletest output
fw4 Filtering traffic with IP sets by DNS
nftables
Simple rule management
Configuring tables
Configuring Shadowsocks rules with nftset in OpenWRT 23
小版本升级,例如 19.05-> 19.07。
这种小版本的升级最方便的就是通过 Attended Sysupgrade 功能,可以保留已安装的包和系统设置。最大限度地无缝过渡。官方介绍:https://openwrt.org/docs/guide-user/installation/attended.sysupgrade
需要先安装 Attended Sysupgrade luci 界面包:
opkg install luci-app-attendedsysupgrade
建议使用此功能前依然做一次数据备份。
然后重新登录 luci,在 system - Attended Sysupgrade 找到入口,点击 search for firmware upgrade 即可在线搜索可更新的系统。
最方便的就是通过 luci 界面升级系统,目前支持直接升级的大版本顺序是:19.07 > 21.02 > 22.03 > 23.05。
openwrt 21:https://openwrt.org/releases/21.02/notes-21.02.0
openwrt 22:https://openwrt.org/releases/22.03/notes-22.03.0
openwrt 23:https://openwrt.org/releases/23.05/notes-23.05.0
每个版本升级实际上就是重新刷入了一次固件,所以之前的配置文件什么的基本上都会被覆盖,所以系统内修改过的配置最好做一次备份。
打开 luci 界面,选择 system - backup/flash firmware,在 configuration 菜单栏中将需要保存的文件或目录定义出来,然后在 action 菜单栏中选择 backup - generate archive 即可保存备份到本地。
可以通过 awk 脚本识别出自己手动安装的包列表,方便更新系统后安装回去,下载脚本:https://github.com/richb-hanover/OpenWrtScripts/blob/main/opkgscript.sh
执行以下命令会保存已安装的包列表到 /etc/config/opkg.installed:
opkgscript.sh -v write
执行以下命令会识别并安装 /etc/config/opkg.installed 列表中的包:
opkgscript.sh -v install
也可以执行以下 awk 脚本可以单独列出自己手动安装的包列表:
#!/usr/bin/awk -f
BEGIN {
ARGV[ARGC++] = "/usr/lib/opkg/status"
cmd="opkg info busybox | grep '^Installed-Time: '"
cmd | getline FLASH_TIME
close(cmd)
FLASH_TIME=substr(FLASH_TIME,17)
}
/^Package:/{PKG= $2}
/^Installed-Time:/{
INSTALLED_TIME= $2
# Find all packages installed after FLASH_TIME
if ( INSTALLED_TIME > FLASH_TIME ) {
cmd="opkg whatdepends " PKG " | wc -l"
cmd | getline WHATDEPENDS
close(cmd)
# If nothing depends on the package, it is installed by user
if ( WHATDEPENDS == 3 ) print PKG
}
}
EOF保存以上内容到 listuserpackages.awk 文件中并执行即可列出用户自行安装包列表。
x86 版本的 openwrt 的升级固件就是全新安装时候用的固件,直接在官网下载需要版本的 gz 压缩包即可。
下载地址:https://downloads.openwrt.org/releases/
我下载的是:generic-ext4-combined.img.gz,注意不要解压出来,保留压缩包即可。
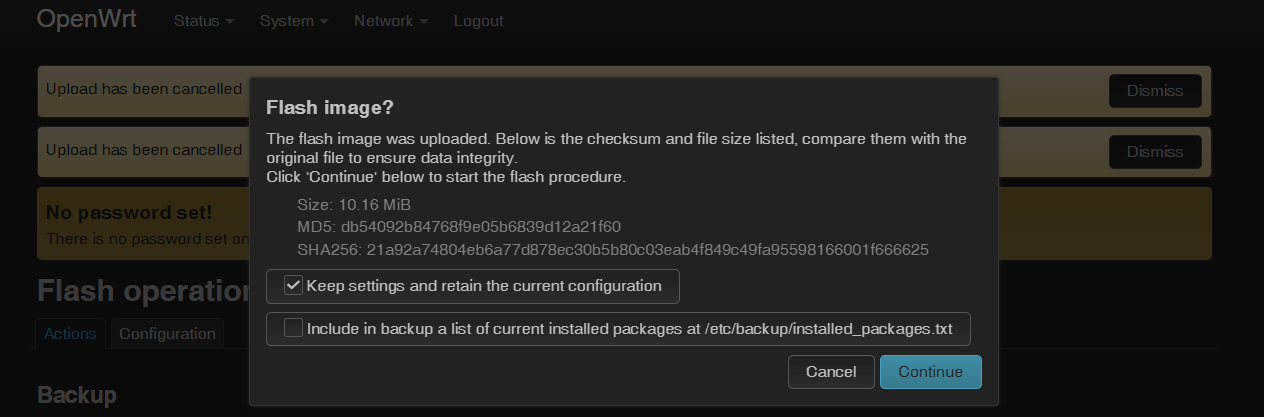
进入 luci 的 system - backup/flash firmware 选择 Flash image ,然后选择刚才下载的压缩包即可上传更新,会提示是否保留设置和配置,跨大版本的升级必须取消选择保留数据,否则可能升级失败:
如果升级后卡在 grub 界面说明可能是由于选择了保留配置导致升级失败了,可以参考官方教程通过 failsafe mode 恢复默认配置:Failsafe mode, factory reset, and recovery mode,或者直接重新安装系统。
稍等几分钟安装好后你可能会发现 luci 无法在局域网中访问了,这是由于新安装的固件恢复了 network 配置,需要直接到 openwrt 设备上配置网络。
配置教程参考:openwrt network 配置
配置好网络后在局域网设备中可以用 ssh 登录了,此时会发现提示:
@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@
@ WARNING: REMOTE HOST IDENTIFICATION HAS CHANGED! @
@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@
IT IS POSSIBLE THAT SOMEONE IS DOING SOMETHING NASTY!
Someone could be eavesdropping on you right now (man-in-the-middle attack)!
It is also possible that a host key has just been changed.
The fingerprint for the RSA key sent by the remote host is
SHA256:U9XODs/7A4k065pxSMyEtQ2m98v2P0bf/ML0MfzU.
Please contact your system administrator.
Add correct host key in C:\\Users\\Marco Nie/.ssh/known_hosts to get rid of this message.
Offending RSA key in C:\\Users\\Marco Nie/.ssh/known_hosts:6
Host key for 192.168.244.1 has changed and you have requested strict checking.
Host key verification failed.这是由于更新系统后 ssh 指纹发生了变化,需要删除本地缓存的 openwrt 设备的指纹在登陆,windows 系统 ssh 指纹保存地址为当前用户目录下的 .ssh 文件夹。
升级后可以通过之前的脚本列出的已安装包的列表将自己需要的包安装回去,同时将备份数据按照新系统的格式恢复回去。
从 openwrt 21 开始修改了 network 配置文件格式,参考:https://blog.niekun.net/archives/2291.html
从 openwrt 22 开始替换 iptables 为 nftables,需要原始工具的话可以自行安装回去:opkg install iptables